関連記事判定とJev
先日、Jevを使って家庭内での立替精算アプリを作りました。JevはLLMのように文章を生成できません。定められた回答形式に従って回答することしかできません。Choiceなら多肢選択式で、Scoreなら評定尺度で、Noulなら二者択一で回答します。かわりに、回答速度が速く、トークン費用が安く、機密情報を出力したり、任意のコードを実行したりできない安心なAIサービスです。
そんな性格のAIサービスなので、ホビーアプリや細かいところを埋める補助的な使い方に向いています。Jevを使って、このブログの関連記事を生成させてみました。精度も上々でした。プロンプトチューニングなどをせずともすっと期待通りの動きをしてくれるのはJevのいいところです。
やったこと
関連記事を選定する流れを説明します。まず各記事のタイトルとdescriptionをコンテキスト(state)としてJevに与えます。そして、 候補記事すべてに対して「この記事は、次に読みたくなる記事ですか?」と質問します。 Noulで回答させ、スコアが高い記事を最大三件関連記事として選出します。Noulは0.5が境界なので、0.5未満の記事は関連記事として表示しません。
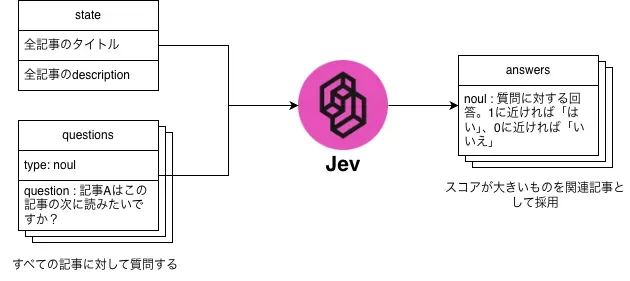
リクエストのJSONは次のようになります。一度にすべての記事に対して関連度を尋ねていることに注目してください。これは投機的ファンアウトパターンと呼び、コストを抑えながら高速に回答を得ることができます。
{
  "state": {
    "current_article": {
      "id": "career-ladder-3",
      "title": "関連記事をつけたい記事のタイトル",
      "description": "関連記事をつけたい記事のdescription"
    },
    "candidate_articles": [
      {
        "id": "career-ladder-1",
        "title": "そのほかの記事のタイトル",
        "description": "そのほかの記事のdescription"
      },
      {...すべての記事を並べます...}
    ]
  },
  "questions": {
    "related_career-ladder-1": {
      "type": "noul",
      "instructions": "candidate_articles のうち id が \"career-ladder-1\" の記事は、current_article の読者にとって、次に読みたくなる関連の深い記事ですか。連載の続き、共通のテーマ、共通の手法のいずれかでつながるなら true と判断してください。語句が似ているだけ、あるいは同じ会社の記事というだけでは false です。"
    },
    {...すべての記事に対して同じ質問をします...}
  }
}
なぜ回答形式にNoulを採用したのか?
関連記事を選ぶ質問なら、「この記事の次に読みたい記事を三つ選択せよ」、つまり回答形式としてChoiceを使うことも検討できます。しかし、Choiceは選択肢の中に単一の正解があることを期待している回答形式です。そのため回答結果で返ってくる確率は、選択肢全体で合計1になる分布をとります。つまり、選択肢の中での相対比較となり、確率の値が高いからといって確からしいとはいえません。
次の例を見てみましょう。Choiceを使って「リンゴと似ているのはどれか?」とJevに質問した結果です。
| 選択肢 | スコア |
|---|---|
| 青森県 | 0.69 |
| 万有引力 | 0.29 |
| アダム | 0.02 |
青森県が強く似ていると判定されました。しかしこれは選択肢の中では強く似ているだけで、本当に概念的に似ているかどうかはわかりません。
次に、Noulを使って「リンゴと{選択肢}は似ているか?」と質問した結果です。
| 選択肢 | スコア |
|---|---|
| 青森県 | 0.54 |
| 万有引力 | 0.39 |
| アダム | 0.37 |
Noulは0.5が境界値なので、0.54はかろうじて似ている程度の判定になります。こちらの方がスコアとしての納得感が強いのではないでしょうか。無理やりにでも関連記事を出したい場合は、ChoiceでもいいかもしれませんがNoulを使う方が素直だと思います。
Noulにはもう一つ優れた特徴があります。絶対評価なのでキャッシュできるということです。N本の記事に対して、「次に読みたい記事」をスコアリングする場合、有向グラフとなるので、質問数はN(N-1)問であり、記事数の二乗に比例して増えてしまいます。しかし、Noulは質問が独立しており、スコアが絶対評価なので、過去に取得したスコアをそのまま使うことができます。過去のスコアをキャッシュしておくことで、記事を新しく追加したときの関連記事の質問数を2N問に抑えることができます。
LLMではだめなのか?
関連記事の判定程度なら、LLMでも問題なくタスクをこなせるように見えます。そこで、LLMで関連記事を評価したときと比較してみました。比較対象は次の三つです。
- Jev(回答方式はNoul)
- LLM(Noul風の確率判定)
- LLM(次に読みたい記事を三つ選択)
LLMのモデルとして今回はトークン単価が近いGemmaを使いました。結果は次の通りです。
| 記事 | Jev(Noul) | LLM(Noul風) | LLM(三記事選択) |
|---|---|---|---|
| キャリアラダー設計③ | ・④(0.96) ・⑤(0.94) ・⑥(0.92) | ・①(1.00) ・②(1.00) ・④(1.00) | ・④ ・② ・① |
| 自己開示 | (なし) | ・1on1とCFR(0.80) | ・1on1とCFR ・OKR改善提案 ・OKRがうまくいかない |
LLMでは連載記事(キャリアラダー設計③)で過去の記事を推薦したり、関係性の薄い記事を選んでしまったりしています。もちろんプロンプトチューニングすればより適切な結果を出力できると思います。しかし、それは言い換えるとJevはあまりチューニングを意識せずとも自然な評価を下せるといえます。
次に、コストと回答速度を見てみましょう。
| 方式 | コスト(入/出力トークン) | 回答速度 |
|---|---|---|
| Jev(Noul) | $0.000192(4,560/330) | 160〜190 ms |
| LLM(Noul風) | $0.000275(1,368/210) | 1,084〜2,052 ms |
| LLM(三記事選択) | $0.000200(1,350/30) | 735〜841 ms |
コストは元々近いモデルを選んでいたことから、あまり大きな差はありませんが、Jevが最も安いです。違いが大きいのは回答速度です。4倍以上速く回答を得られます。これは件数が増えたときに大きな違いとなるでしょう。